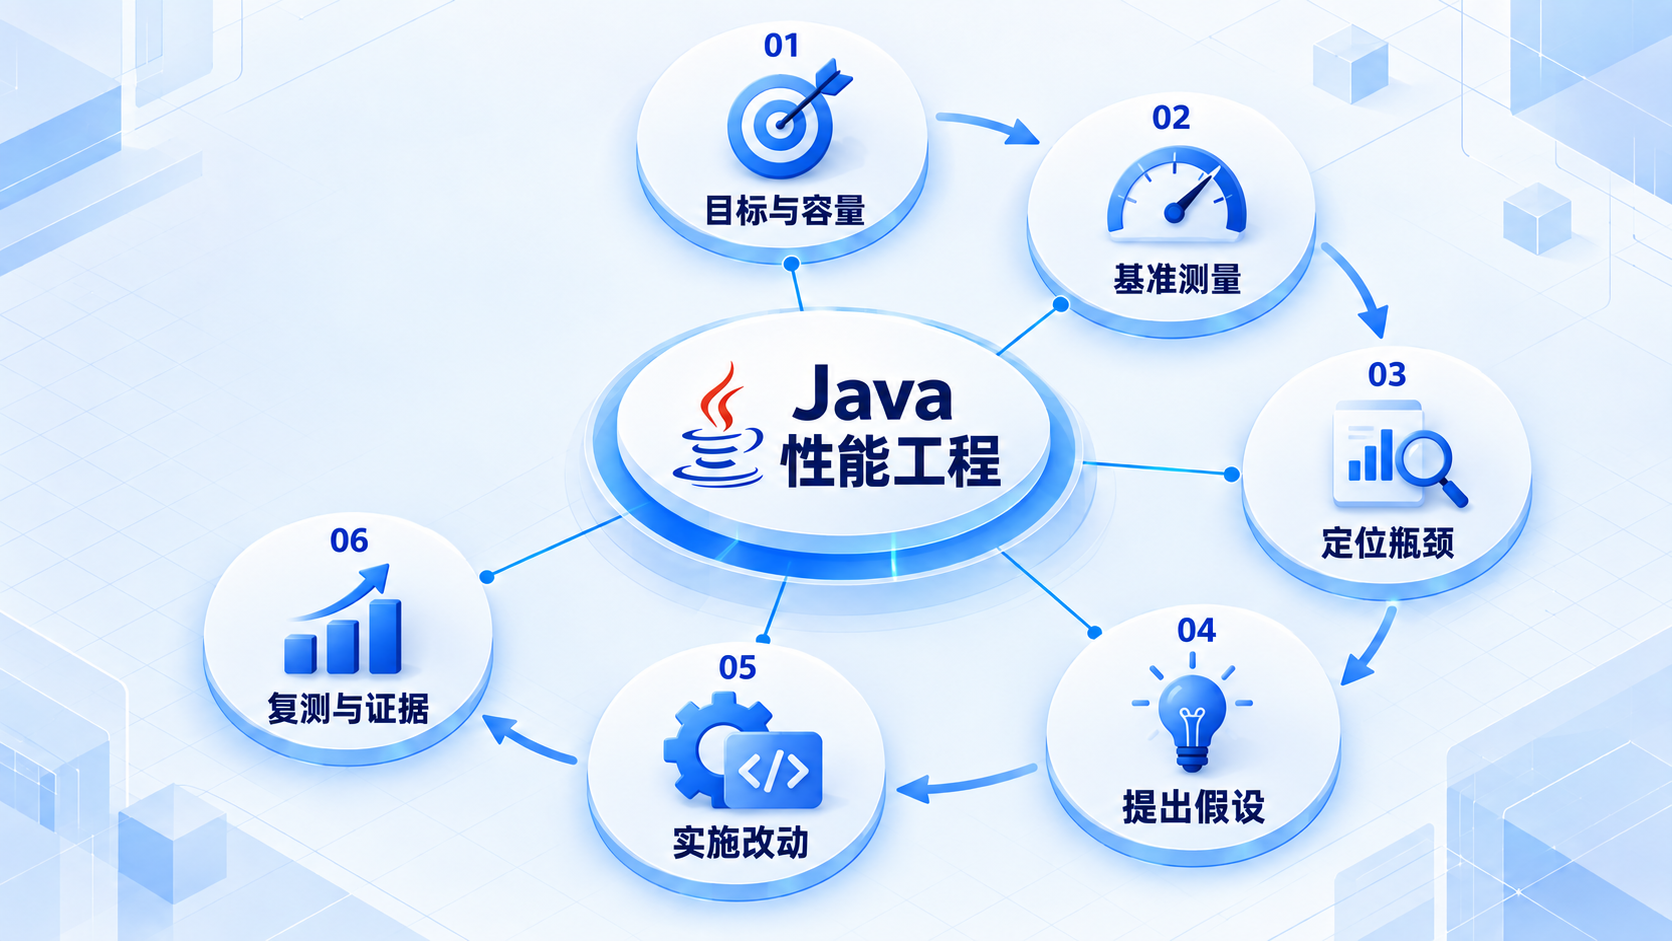
性能工程:Measure → Locate → Hypothesis → Change → Re-measure
用户说“有时打开很慢”,平均响应时间却看起来正常,这时需要看延迟分布。性能学习从这些可观察的问题开始:慢的是多数请求还是少数请求,等待发生在哪里,负载增加后哪种资源先饱和?
版本与资料依据
last_verified:2026-08-24version_scope:JDK 25 production baselinesource_type:OpenJDK/JDK docs + engineering practicestability:version-sensitive
指标
先看每秒完成多少请求,以及响应时间的分布。p50 描述中间位置,p95、p99 帮助观察较慢的一部分请求;单看平均值容易忽略这些等待。
再结合错误率、资源饱和度、队列长度、对象分配速率、GC 停顿、数据库等待和缓存命中情况,判断时间花在了哪里。任何一个指标都不宜单独作为结论。
实验流程
- 固定请求模式、数据集、JDK、容器资源和预热过程,让两次实验可以比较。
- 测出修改前的基线,并确认发请求的机器没有先达到上限。
- 根据现象选择追踪、JFR、GC 日志、线程或堆转储、数据库执行计划,不必每次全用。
- 写出可以被实验推翻的解释,例如“等待来自连接池耗尽”。
- 一次改变一个主要因素,避免成功后也不知道原因。
- 重新测量,比较波动范围、资源使用与功能回归结果。
- 把验证过的容量和服务目标写进运行手册。
加缓存、加线程或改 GC 都不是通用答案。先找瓶颈属于 CPU、allocation/GC、lock、I/O、database、downstream、queue 还是网络。
让性能结论能够被别人复查
给一份实验报告写清:测哪个接口、数据多少、并发多少、持续多久、是否预热、失败请求是否计入结果。再同时记录请求数和延迟分布。样本太少时,p99 往往只是极少数观测值,不能当成稳定的容量结论。
如果怀疑慢在 JVM 内部,可以用短时 JFR 记录核对线程等待和运行活动;如果慢在数据库,继续看查询计划与连接等待。JFR 是证据来源之一,不是自动替你判定根因的裁判。保留修改前后的同条件记录,让读者能复做比较。
本节的核验依据
2026-10-25 查阅。下面的链接支持本节的机制说明;练习场景和选型建议是本教程的教学设计。