flowchart LR
N0["01 访问与瓶颈"]
N1["02 本地缓存"]
N2["03 Redis 缓存"]
N3["04 搜索与索引"]
N4["05 多级与一致性"]
N5["06 热点与治理"]
N0 --> N1 --> N2 --> N3 --> N4 --> N5
缓存与搜索
现代 Java Backend Engineering 学习路线:缓存与搜索
0 子目录5 文档
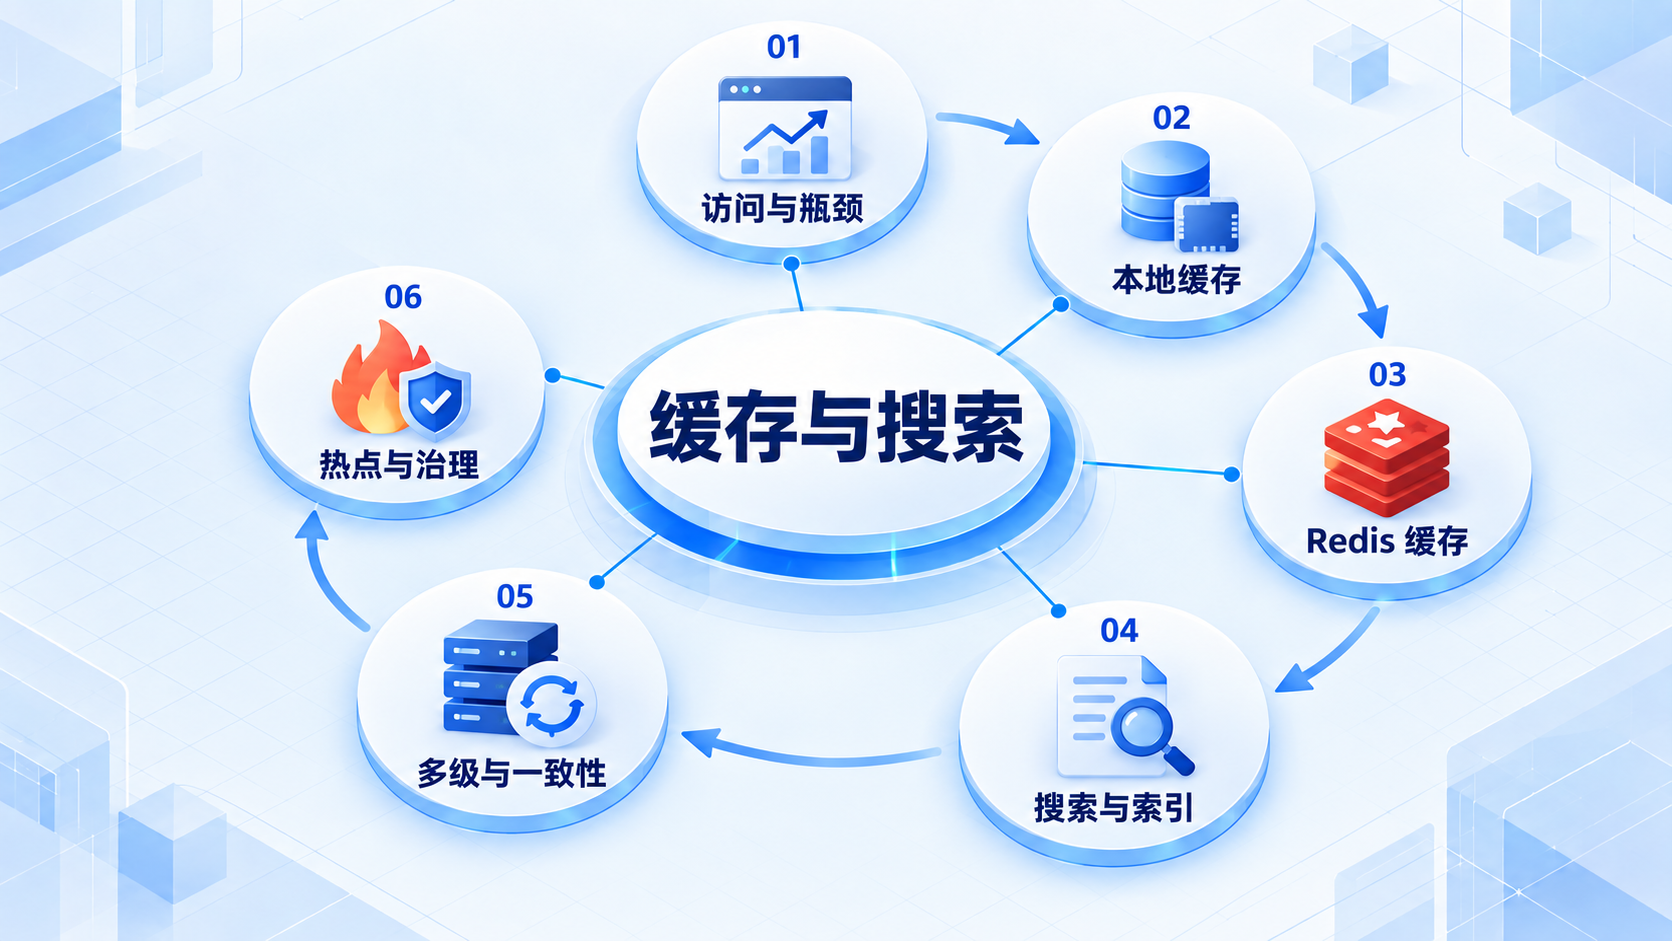
CHAPTER OVERVIEW · 章节概览
先用访问模式和性能证据说明需求,再选择缓存或搜索;始终检查失效、一致性和热点问题。
本章学习路线
箭头表示建议的学习顺序;先理解问题,再逐步进入实现与实践。
按顺序学习
5缓存与搜索:在证据出现后引入想让查询更快之前,先确定数据以哪里为准,以及用户能接受多旧的结果。缓存和搜索索引通常保存另一份表示,更新失败时就可能与原数据不一致。带着这两个问题进入 Redis 和 Elasticsearch,会更容易做取舍。Redis 与缓存工程:数据类型、持久化、高可用、集群与一致性把查询结果放进 Redis 后,下一次读取可能更快,但数据修改后这份缓存怎么办?从这个问题出发,再学过期、淘汰、持久化与复制,能把各种功能连起来,而不是分别背命令。Elasticsearch 搜索工程:Mapping、分析器、Query DSL、分片与聚合用户输入几个词,希望找到相关商品,这与按主键查询一行记录很不一样。Elasticsearch 围绕检索组织数据。下面先看字段怎样建立索引、查询怎样匹配,再讨论分片和更新,别把它当成直接替换关系数据库的工具。缓存、CDN、读写分离、分库分表与热点治理访问变慢时,先检查查询和索引,往往比立即分库分表更划算。下面按从简单到复杂的顺序讨论缓存、CDN 和分片,并解释每多保存一份数据,会增加哪些同步和排错工作。Caffeine 本地缓存与多级缓存如果某份数据很小又经常读取,放在当前 JVM 的内存里可以省去一次网络请求。Caffeine 提供了这类缓存的管理能力。不过部署多个实例后,每个实例都有自己的副本,更新和失效就要另外考虑。