flowchart LR
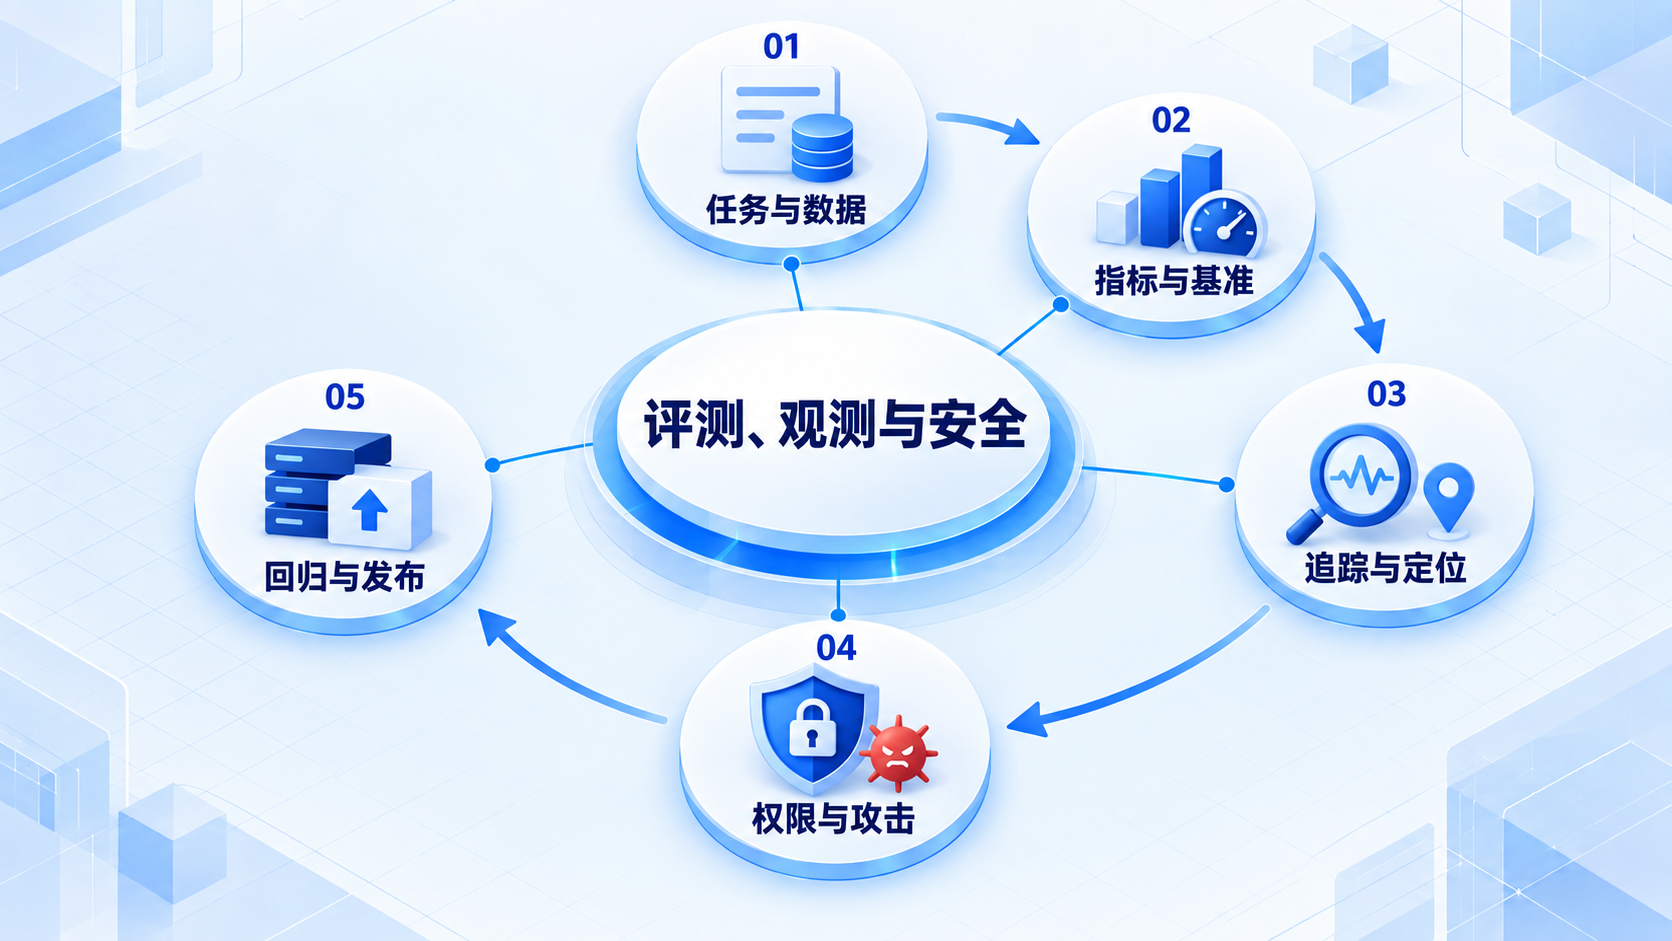
N0["01 任务与数据"]
N1["02 指标与基准"]
N2["03 追踪与定位"]
N3["04 权限与攻击"]
N4["05 回归与发布"]
N0 --> N1 --> N2 --> N3 --> N4
Evaluation Observability Safety
现代 Agent Engineering 学习路线:Evaluation Observability Safety
0 子目录6 文档
CHAPTER OVERVIEW · 章节概览
先定义任务和成功标准,再选择数据、指标和运行证据;将权限与攻击测试纳入回归及发布判断。
本章学习路线
箭头表示建议的学习顺序;先理解问题,再逐步进入实现与实践。
按顺序学习
6Agent Eval:数据集、指标与回归测试改了一段提示词后,有几个任务变好了,也可能有另一些退步。Eval 用固定任务反复检查,帮助我们看见这种取舍。下面先定义成功条件,再记录成本、延迟和失败原因,不只比较一句最终回答。可观测性:Trace、Metrics、Logs 与故障定位指标能告诉你错误变多了,日志能说明某个事件,Trace 则把同一次任务中的事件连起来。三者配合,才能从总体异常走到具体调用。下面围绕一次失败介绍应该怎样关联记录。Prompt Injection、权限边界与 Human-in-the-loopAgent 可能把网页、邮件或工具输出中的内容带回模型,因此需要防止外部文本改变原来的执行权限。人工确认也要放在真正有影响的动作之前。下面把输入来源、工具权限与审批流程一起考虑。Agent Benchmark Map:测量对象、环境、信号与限制不同榜单测量的任务不同,分数不适合脱离环境直接比较。先确定自己的 Agent 要完成什么、允许做什么,再选择有参考价值的基准。本页是查找入口,不是按榜单顺序推荐产品。Evaluation 闭环、Trace 与发布门一次评测结束后,真正有用的不是只留一个总分,而是知道哪些任务退步、为什么退步,以及是否应该发布。下面把数据集、执行记录、检查器和发布条件连起来,让每次改动都有可比较的结果。评测、可观测性与安全推荐阅读选二十个有代表性的小任务,比只展示一次成功演示更适合观察改动效果。阅读评测资料时,重点看任务如何初始化、成功怎样判定、失败记录保存什么,再把方法用到自己的系统上。