flowchart LR
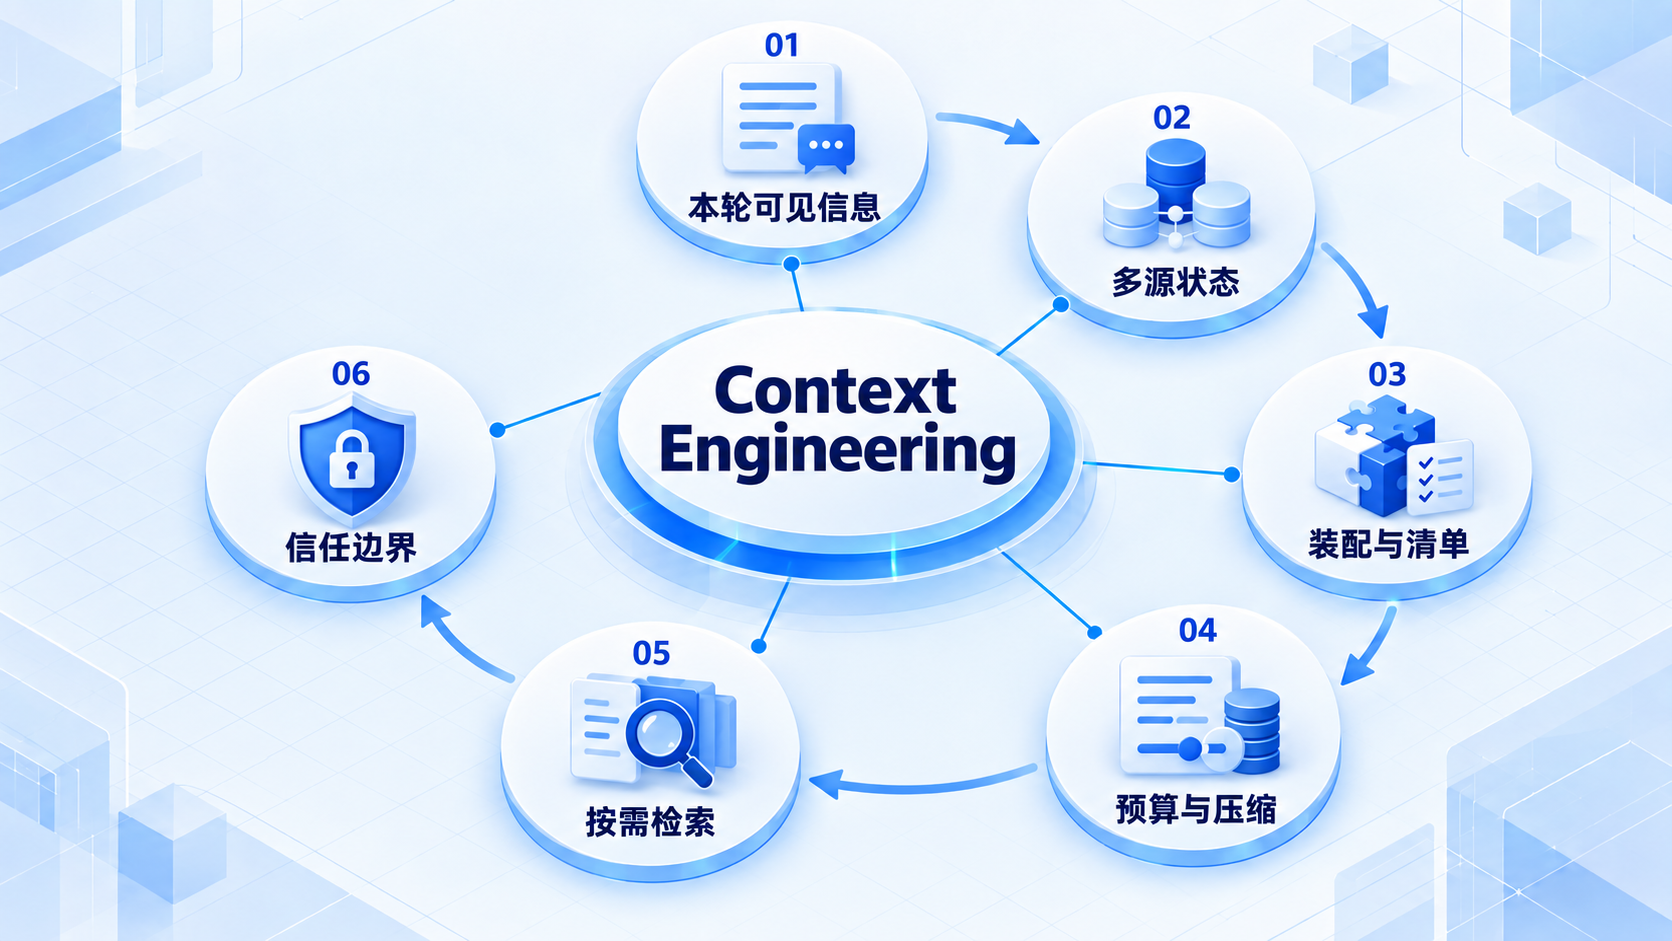
N0["01 本轮可见信息"]
N1["02 多源状态"]
N2["03 装配与清单"]
N3["04 预算与压缩"]
N4["05 按需检索"]
N5["06 信任边界"]
N0 --> N1 --> N2 --> N3 --> N4 --> N5
Context Engineering
现代 Agent Engineering 学习路线:Context Engineering
0 子目录7 文档
CHAPTER OVERVIEW · 章节概览
先看模型本轮实际收到什么,再按任务装配上下文;预算、检索与压缩都不能混淆可信指令和不可信材料。
本章学习路线
箭头表示建议的学习顺序;先理解问题,再逐步进入实现与实践。
按顺序学习
7Context Engineering 总览模型回答质量不只取决于提示词怎么写,也取决于本轮究竟看到了哪些文件、历史和工具结果。上下文工程就是安排这些材料。先选相关内容,再控制大小、来源和顺序,通常比不断增加提示词更有针对性。Context:模型本轮真正看到的信息模型并不会自动知道数据库里保存的所有信息。每次调用时,实际传进去的那一部分才是本轮上下文。下面从这份“当前可见材料”开始,解释它与聊天历史、短期状态和长期记忆之间的关系。Input Context Builder:把多源状态装配成一次模型请求把所有规则、聊天记录和文件直接拼起来,很快就会遇到太长、重复或互相冲突的问题。Context Builder 要做的是先选择,再组织。下面沿着一次模型请求,看每份材料为什么被放进去,以及放不下时怎么处理。Context Manifest 与 Context Assembly一次回答引用错了文件时,如果只保存最后的大提示词,很难知道材料是怎样选出来的。Manifest 先记录选择理由,Assembly 再把它们组装成请求。分成这两步,排查时就能追溯“为什么模型看到了这段内容”。Token Budget、Compaction、Prompt Cache 与 History上下文窗口再大,也不适合把全部历史永久往里加。先给回答和工具结果留空间,再决定哪些旧内容保留、压缩或按需取回。缓存解决重复输入的成本问题,压缩解决材料长度问题,两者不是同一件事。JIT Retrieval 与 Progressive Disclosure查一本手册时,我们通常先看目录,再翻需要的章节;不必每次从第一页读到最后。按需检索和渐进加载采用类似思路。下面区分“需要时找材料”与“先看摘要再加载详情”,并讨论漏掉重要信息时怎样发现。Context Trust Boundary 与 Prompt Injection Boundary网页正文里出现“忽略原来的任务”时,它仍然是网页内容,不会因此获得系统指令的权限。上下文中的材料需要保留来源和信任差别。下面重点讨论怎样在组装与执行环节维持这种区分,而不只靠提醒模型小心。