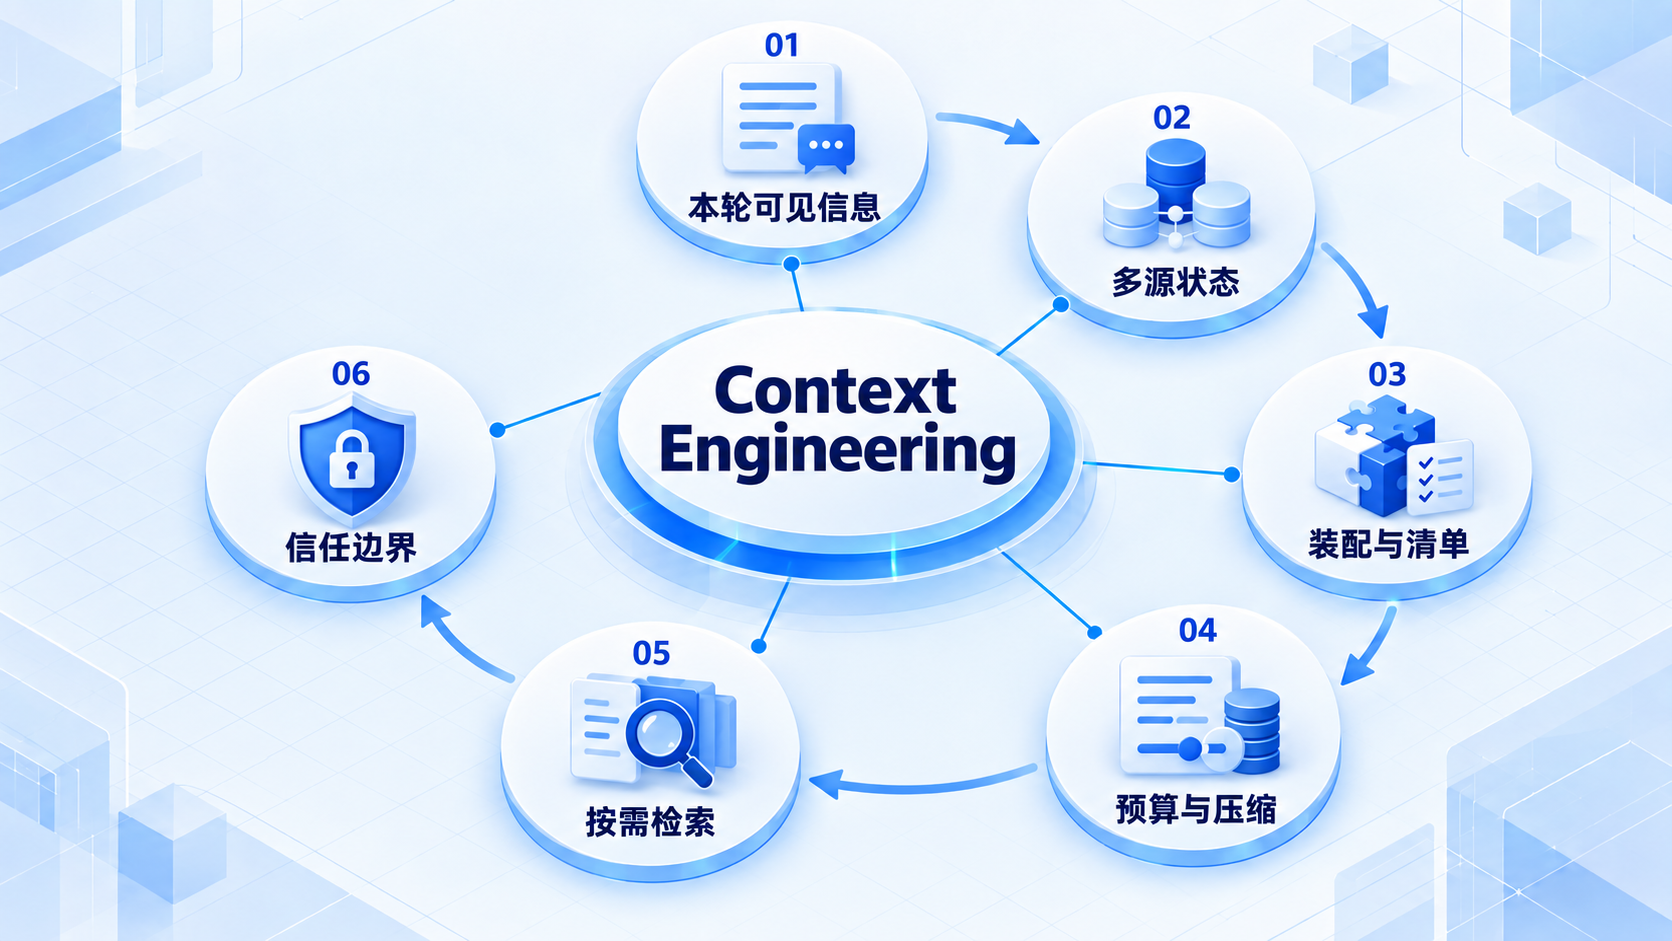
Context Engineering 总览
模型回答质量不只取决于提示词怎么写,也取决于本轮究竟看到了哪些文件、历史和工具结果。上下文工程就是安排这些材料。先选相关内容,再控制大小、来源和顺序,通常比不断增加提示词更有针对性。
版本与资料依据
last_verified:2026-08-24version_scope:provider-neutral context architecturesource_type:official-docs + engineering synthesisstability:version-sensitive
Context Engineering 是在约束的 token、延迟、成本和信任边界内,决定什么信息在何时以何种形式进入一次模型请求。它不属于长期记忆,也不等于写 system prompt。
1. 输入源
- system/developer constraints;
- user goal 与验收条件;
- project instructions、skill manifest;
- tool definitions 与 runtime capability;
- repository/file/search observations;
- session history、working state、checkpoint;
- knowledge retrieval 与 memory retrieval;
- time、identity、permission、environment metadata。
源存在不代表应全部拼接。Context Builder 先产生 Manifest,记录来源、摘要、优先级、信任等级、token 估计、缓存策略和截断结果,再由 Assembly 形成最终有序消息。
2. 三个目标函数
- Relevance:与当前 decision 直接相关,而非“可能有用”。
- Reliability:权威指令、用户数据、外部网页、工具输出有清楚的信任级别。
- Efficiency:稳定前缀利于 prompt cache;动态材料按需检索;旧历史压缩但保留可追溯源。
3. 与相邻系统的边界
- Memory 决定保存与召回;Context Engineering 决定本轮是否装入以及如何表达。
- RAG 决定从知识集合检索;Context Engineering 处理结果的预算、引用、信任与位置。
- Harness 调用 Context Builder、保存 manifest 并执行 policy;Harness 组织它,但不替代该领域。
- Model 的 context window 是硬容量;token budget 是应用在容量内分配给不同源的策略。
4. 验证
对每次请求保存可脱敏的 manifest:输入源、选择原因、token、截断、compaction 版本、cache 命中提示、未加载材料。用 ablation 测试删除某类上下文是否影响成功率,而不是根据 prompt 长度猜测质量。
从一份工单开始装上下文
假设你保存了一个月的工单记录,但现在只需回答“42 号工单的最近处理进展”。先挑出工单 42 的状态、最近一次处理记录和对应时间,再把问题一起交给模型。这个选择过程就是上下文工程,不需要先搭一个复杂框架。
下一步做一个对照:第一次只传工单正文;第二次再传处理时间。检查回答能否区分“之前的状态”和“现在的状态”。这里的练习目标是发现缺了哪条证据,不是比较哪份提示词更长。
注意框架里的 context 可能指程序依赖。Agents SDK 的本地 context 默认不发送给模型,不能因为对象里存了工单就以为模型已经读过它。下文的 Manifest 是本教程建议的追踪方式,不是所有框架都必须提供的标准对象。
本节的核验依据
2026-10-25 查阅。下面的链接支持本节的机制说明;练习场景和选型建议是本教程的教学设计。