flowchart LR
N0["01 镜像与容器"]
N1["02 工作负载编排"]
N2["03 网络与配置"]
N3["04 持续交付"]
N4["05 迁移与回滚"]
N5["06 遥测与响应"]
N0 --> N1 --> N2 --> N3 --> N4 --> N5
云原生DevOps与可观测性
现代 Java Backend Engineering 学习路线:云原生DevOps与可观测性
0 子目录6 文档
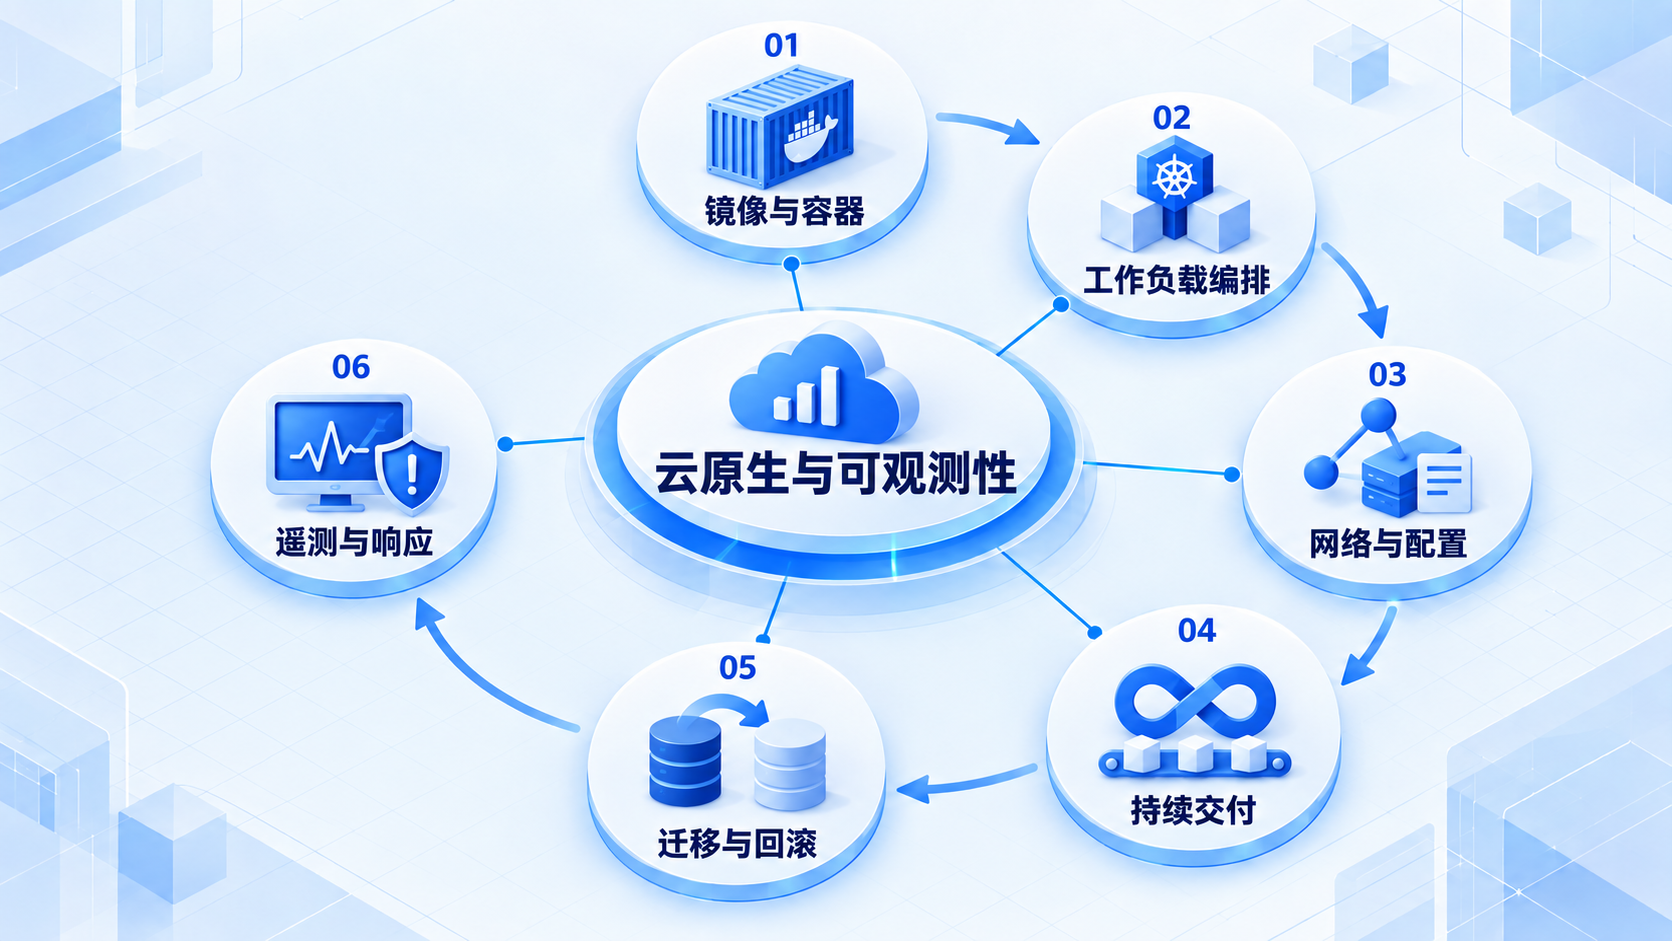
CHAPTER OVERVIEW · 章节概览
先把服务打包成可重复运行的镜像,再学习编排和交付;上线后用遥测、目标与故障响应维持可用性。
本章学习路线
箭头表示建议的学习顺序;先理解问题,再逐步进入实现与实践。
按顺序学习
6云原生、DevOps 与可观测性:从零开始的阶段导学打出 jar 包只是交付的一步。接下来还要让它带着正确配置启动,判断是否健康,出现问题时找到原因并回退。这一阶段沿着上线过程介绍容器、部署和可观测性,而不是从一大段 YAML 开始。Docker:镜像、容器、Compose 与供应链本地容器能启动,不等于镜像已经适合交付。依赖从哪里来、以什么用户运行、收到停止信号后怎样退出,都需要检查。下面从构建一个小镜像开始,再看 Compose 和供应链记录。Kubernetes:工作负载、网络、配置、Secret 与探针Kubernetes 不会替应用理解业务,它主要不断协调实际状态与声明的期望状态。应用要主动告诉平台何时可接流量、何时需要重启,并正确处理停止。下面围绕一个服务的部署过程学习这些配合方式。CI/CD、发布策略、数据库迁移与回滚一次发布可能同时包含应用代码和数据库结构变化。应用回滚了,数据库却未必能直接退回去。下面把构建、验证、发布与迁移按顺序安排,重点讨论出问题后怎样减少影响,而不只展示成功路径。OpenTelemetry、SLO、告警与故障响应报警响起时,最需要知道的是谁受影响、从什么时候开始、接下来查哪里。日志、指标与追踪要围绕这些问题组织。SLO 则帮助团队明确可接受的服务水平,避免每一点波动都触发同样的响应。云原生、DevOps 与可观测性推荐阅读这一组资料适合配合一个已经能运行的小服务阅读:先做镜像,再部署,再观察一次发布和故障。每一步都留下可重复的命令,下一次发布才不必重新凭记忆操作。