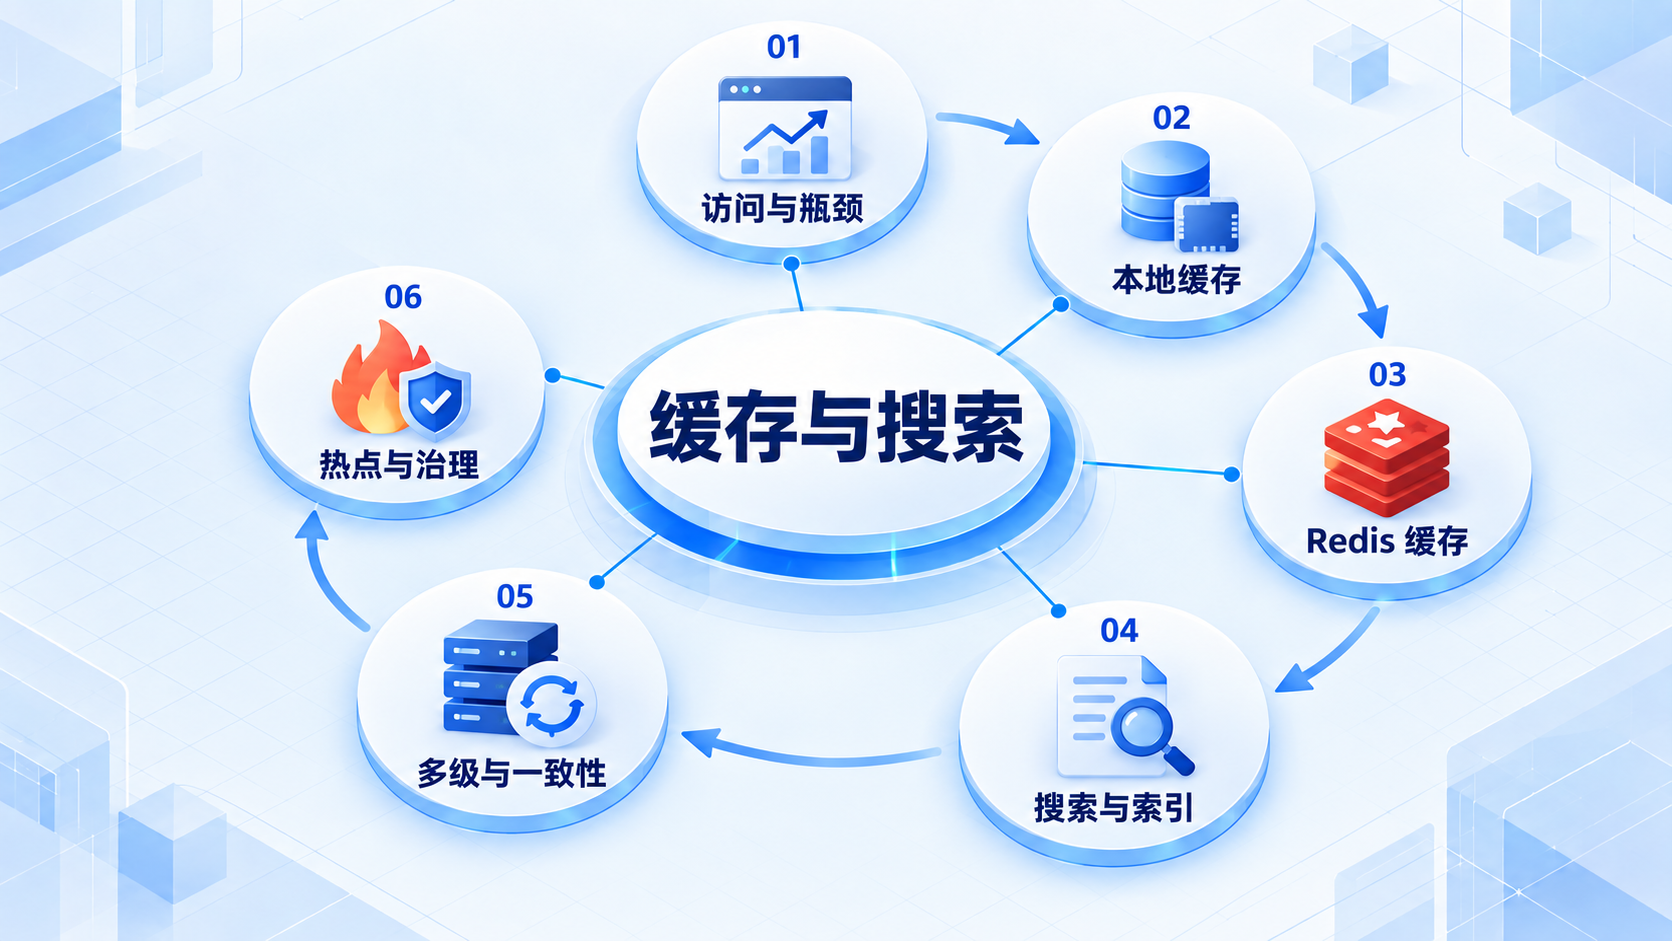
缓存与搜索:在证据出现后引入
想让查询更快之前,先确定数据以哪里为准,以及用户能接受多旧的结果。缓存和搜索索引通常保存另一份表示,更新失败时就可能与原数据不一致。带着这两个问题进入 Redis 和 Elasticsearch,会更容易做取舍。
版本与资料依据
last_verified:2026-08-24version_scope:Redis / Caffeine / Elasticsearch conceptssource_type:official-docsstability:version-sensitive
Redis 不是“更快数据库”,Elasticsearch 也不是关系数据库的默认替代品。先定义 source of truth、查询/延迟目标、一致性窗口和失败回退。
Redis/Cache
data structures、cache-aside、TTL+jitter、hot/big key、penetration/breakdown/avalanche、consistency、distributed-lock boundary;本地 Caffeine 可减少网络开销,多级缓存必须解决 invalidation 与实例间陈旧。
Search
inverted index、mapping/analyzer、query/filter、aggregation、refresh、shard;关系库负责事务事实,搜索索引通常由 CDC/outbox 异步构建,接受可测的 freshness lag。
验证指标
hit ratio 与 miss cost、p95/p99、eviction、memory fragmentation、hot-key distribution、index lag、search relevance、fallback success。缓存命中率高但源数据错误仍是失败。
先观察“写成功但暂时搜不到”
在搜索练习里新增一篇文章,然后立即查询关键词。写入成功与出现在搜索结果中不一定是同一时刻:Elasticsearch 的搜索可见性与 refresh 有关。先记录可见性延迟,再讨论读者能接受多久。
接着模拟索引更新失败:详情页从主数据读取时可能已显示新标题,搜索列表仍是旧标题。把更新任务做成可重试、可核对的过程,并展示合适的状态提示。不要通过每次写入都强制刷新来掩盖所有问题;先理解代价,再根据需求选择。
本节的核验依据
2026-10-25 查阅。下面的链接支持本节的机制说明;练习场景和选型建议是本教程的教学设计。