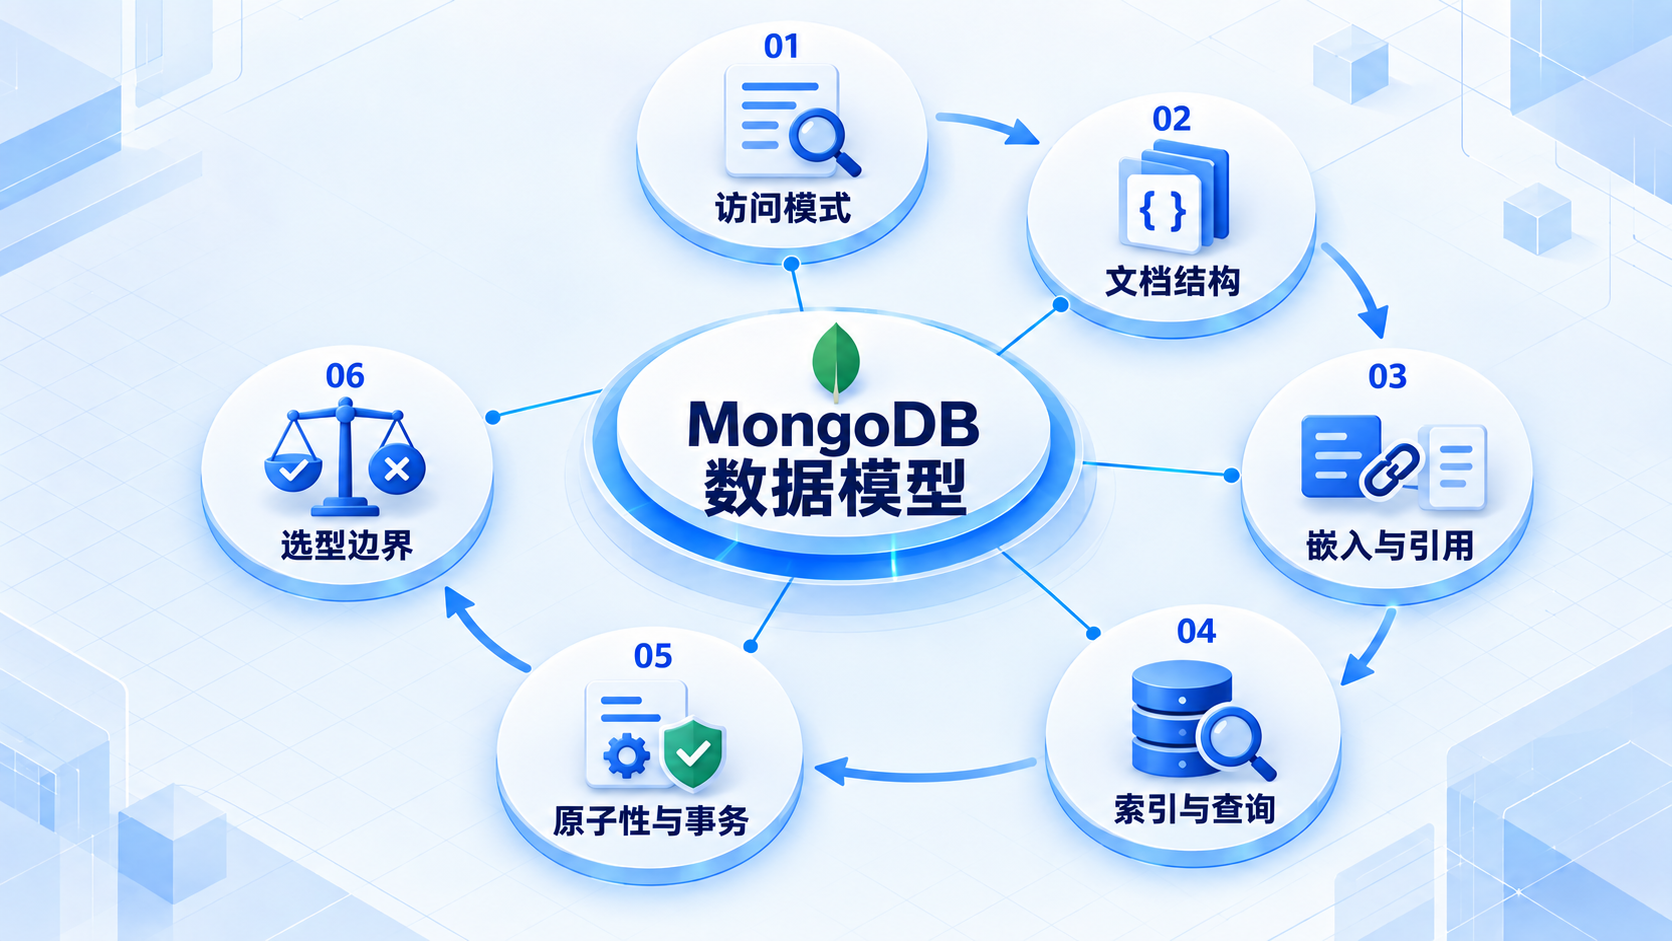
MongoDB 文档模型与选型(可选)
把相关数据放进一个文档,读取时可能很方便,但独立增长的数据也可能让文档越来越难维护。学习 MongoDB 时,先列出实际读写操作,再选择嵌入或引用,而不是把关系表原样换成 JSON。
版本与资料依据
last_verified:2026-08-24version_scope:MongoDB concepts; verify server/driver versionssource_type:MongoDB official docsstability:version-sensitive
MongoDB 适合以文档聚合读取/写入、schema 演进与水平扩展需求明确的场景。建模从访问模式出发:一起读取且生命周期一致的数据可嵌入;独立增长、共享或高基数关系考虑引用。
必须学习 _id、document size、index、compound index、aggregation pipeline、transactions、read/write concern、replica set、sharding 与 schema validation。它不是“无 schema”,而是 schema 约束位置更灵活。
选择前比较关系一致性、join/analytics、更新模式、团队运维与数据迁移;不要因 JSON 方便就替换关系数据库。
从订单地址与评论列表理解嵌入和引用
订单里的收货地址通常需要保留“下单当时”的样子,可以作为订单文档的一部分。用户后来修改个人地址,不应自动改写历史订单。这个例子说明,数据是否一起读写、生命周期是否一致,比“都是 JSON”更重要。
另一边,文章评论可能持续增长,还要单独分页、审核和删除。把所有评论塞进一篇文章文档,未必合适;可把评论放在独立集合,用文章 ID 关联。这里是建模练习,不是所有订单或评论系统的唯一设计。最终用访问模式、文档大小与一致性需求验证。
本节的核验依据
2026-10-25 查阅。下面的链接支持本节的机制说明;练习场景和选型建议是本教程的教学设计。