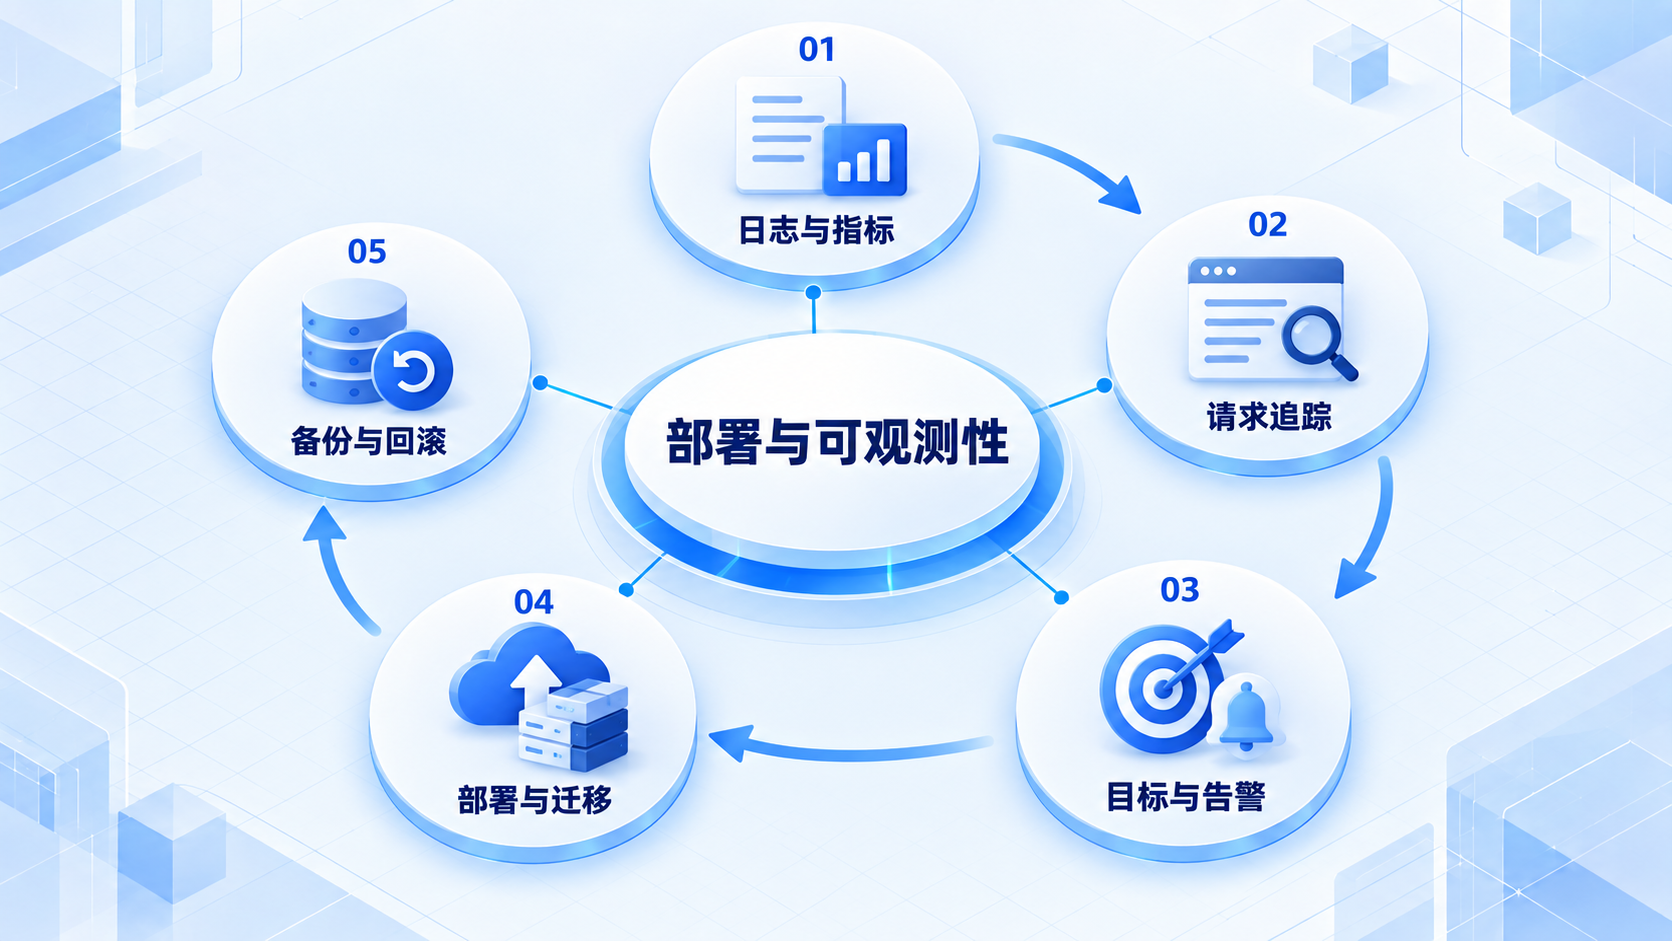
日志、指标、追踪与 SLO:从“有报错”到知道哪里坏了
用户说下单很慢,日志里却全是 200。也许请求排队了两秒,也许少数用户一直失败,只是平均值把问题盖住。可观测性要帮助回答具体问题,而不只是安装一套监控面板。
1. 三类信号各有什么用
日志适合记录离散事件及上下文,例如某个订单状态转换失败;指标适合聚合比较,例如过去五分钟的错误率;追踪把一次操作经过的多个服务和步骤连起来。它们互相补充,不是收集越多就自然越清楚。
可以在受控日志中记录 request ID、trace ID、操作名、耗时和结果代码。指标标签避免使用无限增长的用户 ID、订单 ID 或原始 URL,否则高基数会增加资源成本。URL 模板 /orders/:id 通常比每个实际订单路径更合适。
{
"level": "info",
"operation": "place_order",
"requestId": "req-demo-42",
"durationMs": 86,
"outcome": "created"
}
这是日志结构示意,没包含凭据或完整用户输入。request ID 帮助关联事件,但未必具有分布式 trace 的父子关系和采样语义。
2. 先看用户可感知的四类现象
延迟、流量、错误和饱和度是常用观察维度。饱和度包括线程池、连接池、队列和磁盘等资源逼近上限的表现,不只是 CPU 百分比。错误也要区分业务拒绝、客户端参数错误和服务故障。
p95 表示该统计集合里 95% 的观察值不超过这个值,不是“每个用户都有 95% 概率这么快”。不同实例的 p95 不能直接取平均当全局 p95,应使用可聚合的分布数据。还要注意样本量与时间窗口。
3. SLI、SLO 与错误预算
SLI 是测量指标,SLO 是目标,SLA 通常涉及对外承诺与约定后果。比如“过去 30 天有效下单请求中,成功比例至少 99.9%”是一种 SLO 描述,仍需定义什么是有效请求、哪些结果算成功。
错误预算表达目标允许的未达标空间。若按请求计数,100 万次有效请求、99.9% 目标对应 1000 次失败预算;若按时间计量则是另一种计算。不能把两者不加说明地互换。
在预算快速消耗时优先修复可靠性或放慢变更,而不是因为面板还绿就继续冒险。SLO 目标来自用户需求与成本权衡,不是每个服务一律写 100%。
4. 告警应该触发行动
“CPU 短暂达到 80%”不一定值得半夜叫醒人;持续影响下单成功率或严重积压则可能需要立即处理。每条告警附上负责人、影响、排查入口和缓解步骤。无人处理的告警数量再多也不构成保障。
追踪中看到数据库跨度很长,可以继续区分连接池等待、锁等待和查询执行。开启采样后要明确哪些请求被保留,缺少 trace 并不证明请求没发生。敏感字段在采集前就应过滤,而不是等泄露后删除面板。
练习与参考
给下单添加一次受控的数据库延迟,确认指标能显示尾延迟变化,trace 能找到数据库步骤,日志能用同一请求关联。然后写一条带处理步骤的告警,不把测试中的固定阈值直接当生产标准。