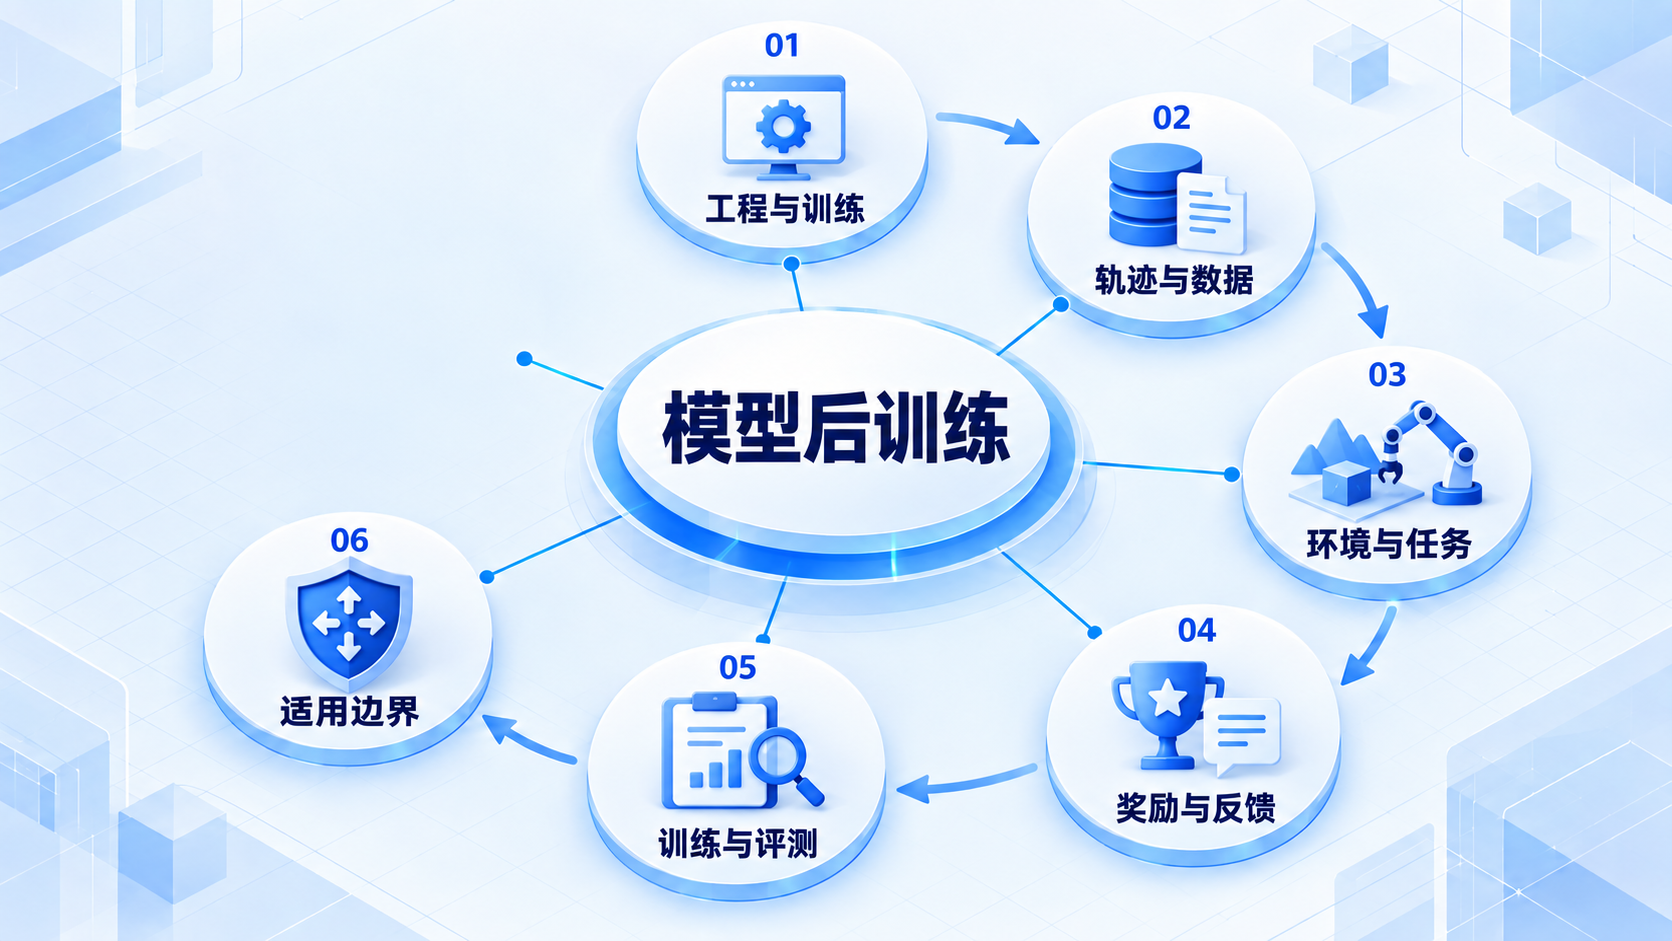
Model Post-training:Agent 工程的可选高级轨道
Agent 表现不好,不一定需要训练新模型。先检查它是否拿到了正确材料、工具是否正常、完成条件是否明确。确认存在稳定的模型能力缺口后,再进入后训练;这一章是可选进阶,不是开发 Agent 的前提。
版本与资料依据
last_verified:2026-08-24version_scope:2026 post-training conceptssource_type:primary-paper + official-researchstability:version-sensitive
后训练是什么,为什么不是第一步
可以把已经能理解和生成语言的模型看成起点。后训练是在这个起点上,用示范、偏好或任务反馈继续调整模型,使它更符合目标行为。它会涉及参数或适配器的更新;仅仅给请求加一段提示词,不属于同一件事。
例如,Agent 总把工单编号填进用户名字段。先检查工具说明是否含糊、schema 是否缺少约束、返回错误是否清楚。如果这些已经改好,模型在大量同类任务中仍反复犯错,才值得考虑收集高质量示范用于训练。否则训练可能只是在掩盖一个容易修复的接口问题。
SFT 像给出“这个输入下,合理输出是什么”的示范;RL 则让策略根据奖励信号调整。两者都不是把所有日志直接喂进去:失败轨迹、泄漏的测试答案和过期工具格式会污染学习目标。先分开训练与评估数据,并用实际工具环境验收。原书对应内容现位于第 8 章。
1. 先区分两条改进路径
| Harness Improvement | Model Improvement |
|---|---|
| context selection、tools、permissions、retry、validator、workflow | 改变模型参数或专门适配器 |
| 迭代快、可解释、容易回滚 | 需要数据、训练算力、模型评测与部署 |
| 适合工具错误、状态与控制问题 | 适合稳定重复的模型能力缺口 |
构建 Agent 并不要求训练模型。多数早期失败应先定位是否由缺失 context、schema、runtime、permission、validation 或预算造成。
2. 方法
- SFT:从高质量输入—目标轨迹学习行为;
- Preference optimization:从偏好对/排序优化输出选择;
- RL / Agentic RL:在环境交互中根据 reward 优化策略;
- Tool-use training:训练 tool selection、argument、result interpretation;
- Trajectory data:包含 observation/action/result/credit,而不只是最终答案。
3. 难点
奖励指标可能被钻空子:模型得到了高分,却没有完成真正的任务。任务很长时,还难以判断哪一步动作对最终结果有贡献,这就是信用分配问题。环境变化会增加结果波动,旧轨迹里的工具格式也可能已经过时。
因此训练、验证与隐藏评测应分开保存,最后还要把模型放回真实 Harness 测试。训练效果变好,不会自动修好工具权限或运行时错误。