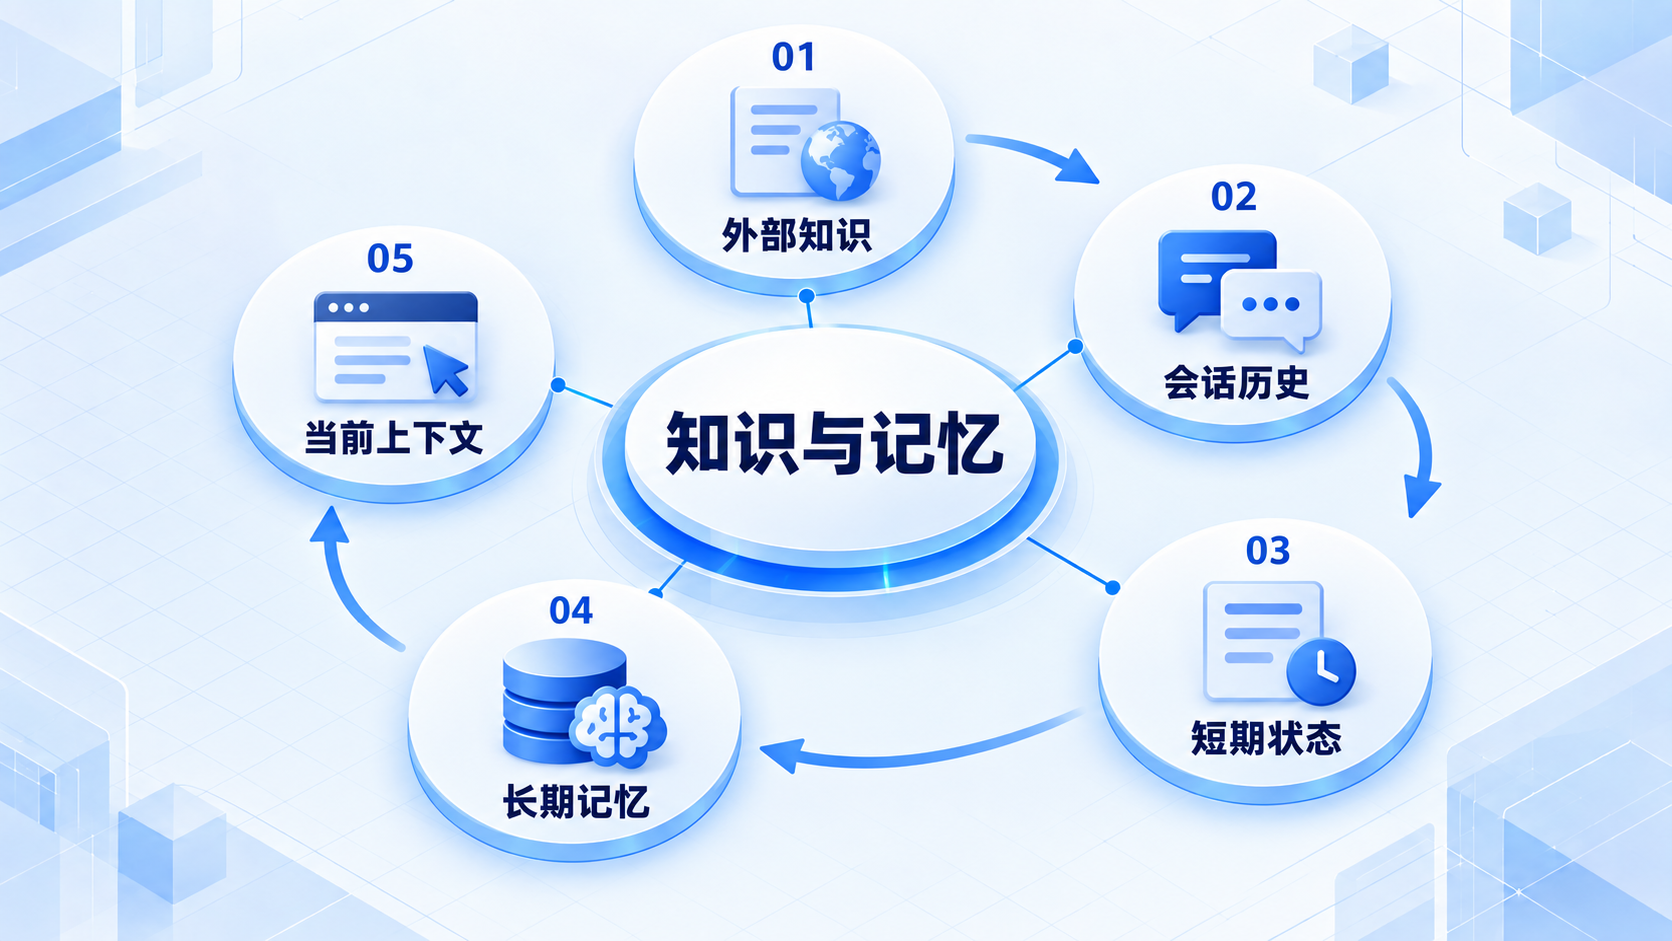
Knowledge、Memory、Context 与 History 的边界
同一段信息可以先出现在聊天记录里,后来被提炼成记忆,再在某次请求中进入上下文。因此这些词有关联,却不是同义词。下面按信息如何保存、为什么取出、何时交给模型来区分它们。
版本与资料依据
last_verified:2026-08-24version_scope:stable engineering conceptssource_type:primary-paper + engineering synthesisstability:stable-concept
| 系统 | 主要对象 | 写入依据 | 读取依据 | 治理重点 |
|---|---|---|---|---|
| Knowledge/RAG | 外部事实与文档 | ingestion pipeline | query/retrieval | citation、freshness、ACL |
| Memory | 任务、事件、用户偏好、学习结果 | write policy | current need | consent、conflict、forgetting |
| Context | 本轮可见材料 | assembly decision | model request | token、trust、ordering |
| History | 会话事件日志 | runtime event | replay/compaction | pairing、trace、retention |
表格可以用一个例子理解:产品手册属于知识资料;用户希望使用简体中文,可以在合适条件下记为偏好;本轮选出的手册片段与偏好进入上下文;这次交互产生的事件再写入历史。信息可能在几层之间流动,但保存目的不同。因此 Context != Memory、Memory != RAG,聊天历史也不自动等于长期记忆。
Knowledge 子系统负责 ingestion、chunking、index、embedding、hybrid retrieval、rerank、citation、grounding 和 Agentic RAG;Memory 子系统负责 working/session/episodic/semantic/long-term user memory 的写入、检索、更新、冲突与遗忘。两者的输出都必须经过 Context Builder 的预算与信任策略后才进入模型请求。
失败模式
- 把所有聊天写入长期记忆,产生隐私、污染和冲突;
- 检索结果无版本/来源,模型无法给出 grounded answer;
- 仅按向量相似度召回权限不匹配的数据;
- memory 更新覆盖原记录却没有 provenance;
- context compaction 被误写回长期 memory,放大摘要漂移。
验证
分别测 retrieval recall/citation correctness、memory write precision/forget success、context selection ablation;不要用“向量库命中”代替端到端任务成功。
同一条信息,按用途选择存放位置
“团队发布流程”适合作为可版本化的知识资料;“这次发布已检查到第三步”属于当前任务状态;“用户偏好中文回复”可能是跨会话记忆。先说清用途,再选数据库或向量库,顺序会更自然。
在 LangGraph 中,checkpointer 面向某个 thread 的状态快照,store 用于图状态之外的跨 thread 数据。这是具体框架的分工,不等于所有记忆都必须向量化。即使都落在 PostgreSQL,也仍要区分作用域、保留时间和访问权限。
练习:开两个会话,只在第一个会话记录“发布到第三步”。第二个会话是否应该看到它?再给用户偏好加上用户 ID,检查换一个用户以后是否还会读到。答案应由产品的数据边界决定,而不是由向量相似度决定。
本节的核验依据
2026-10-25 查阅。下面的链接支持本节的机制说明;练习场景和选型建议是本教程的教学设计。