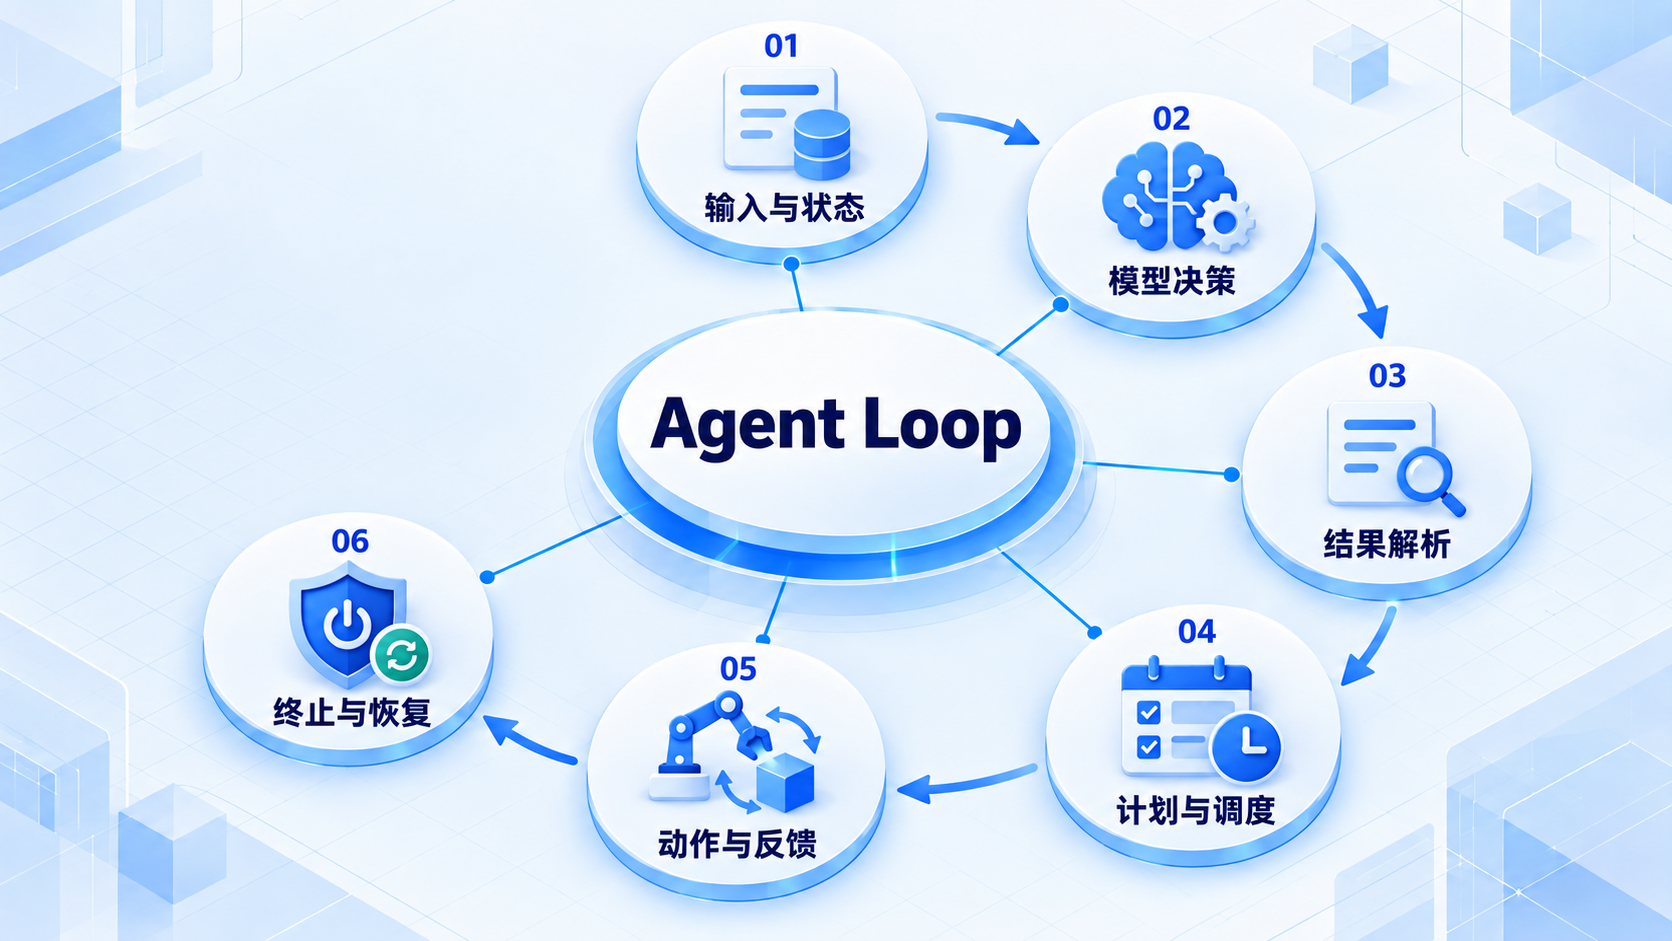
最小 Agent Loop 实现
先不要加入计划器和多 Agent。我们只做一个循环:把当前消息交给模型,执行它请求的工具,再把结果交回去。等这条路径清楚以后,再加入步数、超时和取消限制,保证它不只会启动,也能结束。
1. 最小组成
一个可运行的最小 Agent 至少包含:
- LLM client;
- 对话与状态容器;
- 工具定义和 JSON Schema;
- tool call 解析;
- 参数校验与工具执行;
- tool result 回填;
- 最终答案识别;
- 最大步数、超时、取消和错误分类。
“模型输出一段 JSON”只是决策,不是完整闭环。只有结果回填后模型继续判断,才形成 Agent Loop。
2. 消息顺序
通用顺序如下:
system: 目标、规则、工具说明
user: 当前任务
assistant: tool_call(id=call_1, name=read_file, args={...})
tool: tool_result(tool_call_id=call_1, content={...})
assistant: tool_call(...) 或 final_answer
关键不变量是每个调用 ID 与结果对应。并行调用时,也要保持协议要求的结果集合和顺序。
3. 协议伪代码:先看清每轮先后关系
下面四段是同一逻辑的教学伪代码,Tool、模型适配器、schema 与执行器都需另行实现,并非可直接复制运行的 SDK。执行器必须负责权限、异常归一化与取消;循环条件只检查轮与轮之间,不能打断已经卡住的调用。计时预算应使用单调时钟,例如 JavaScript 初始化为 deadline = performance.now() + timeoutMs,检查时也使用同一时钟;重启后的 deadline 则需另外持久化和换算。
async def run_agent(goal, tools, options):
state = create_initial_state(goal, options)
while state.step < state.max_steps and now_ms() < state.deadline:
response = await call_model(
messages=state.messages,
tools=[to_tool_schema(tool) for tool in tools],
abort_signal=state.abort_signal,
)
if response.type == "final":
return validate_final(response.text, state)
state.messages.append(to_assistant_message(response))
for call in response.tool_calls:
check_remaining_budget_and_cancellation(state)
tool = find_tool(tools, call.name)
if tool is None:
state.messages.append(to_tool_result_message(call.id, unknown_tool_result(call.name)))
continue
parsed = tool.input_schema.safe_parse(call.arguments)
result = (
await execute_with_timeout(tool, parsed.data)
if parsed.success
else invalid_arguments_result(parsed.error)
)
state.messages.append(to_tool_result_message(call.id, result))
state.trace.append({"call": call, "result": result})
state.step += 1
return stop_result(state)
async fn run_agent(
goal: &str,
tools: &[Tool],
options: Options,
) -> Result<FinalResult, AgentError> {
let mut state = create_initial_state(goal, options);
while state.step < state.max_steps && now_ms() < state.deadline {
let response = call_model(
&state.messages,
tools.iter().map(to_tool_schema).collect(),
&state.abort_signal,
)
.await?;
if let ModelResponse::Final { text } = response {
return Ok(validate_final(&text, &state));
}
state.messages.push(to_assistant_message(&response));
for call in response.tool_calls() {
check_remaining_budget_and_cancellation(&state)?;
let tool = find_tool(tools, &call.name)?;
let result = match tool.input_schema.safe_parse(&call.arguments) {
Ok(input) => execute_with_timeout(tool, input).await,
Err(error) => invalid_arguments_result(error),
};
state.messages.push(to_tool_result_message(&call.id, &result));
state.trace.push(TraceItem { call, result });
}
state.step += 1;
}
Ok(stop_result(&state))
}
async function runAgent(goal, tools, options) {
const state = createInitialState(goal, options)
while (state.step < state.maxSteps && performance.now() < state.deadline) {
const response = await callModel({
messages: state.messages,
tools: tools.map(toToolSchema),
signal: state.abortSignal,
})
if (response.type === 'final') return validateFinal(response.text, state)
state.messages.push(toAssistantMessage(response))
for (const call of response.toolCalls) {
checkRemainingBudgetAndCancellation(state)
const tool = findTool(tools, call.name)
if (!tool) {
state.messages.push(toToolResultMessage(call.id, unknownToolResult(call.name)))
continue
}
const parsed = tool.inputSchema.safeParse(call.arguments)
const result = parsed.success
? await executeWithTimeout(tool, parsed.data)
: invalidArgumentsResult(parsed.error)
state.messages.push(toToolResultMessage(call.id, result))
state.trace.push({ call, result })
}
state.step += 1
}
return stopResult(state)
}
async function runAgent(goal: string, tools: Tool[], options: Options) {
const state = createInitialState(goal, options)
while (state.step < state.maxSteps && performance.now() < state.deadline) {
const response = await callModel({
messages: state.messages,
tools: tools.map(toToolSchema),
signal: state.abortSignal,
})
if (response.type === 'final') {
return validateFinal(response.text, state)
}
state.messages.push(toAssistantMessage(response))
for (const call of response.toolCalls) {
checkRemainingBudgetAndCancellation(state)
const tool = findTool(tools, call.name)
if (!tool) {
state.messages.push(toToolResultMessage(call.id, unknownToolResult(call.name)))
continue
}
const parsed = tool.inputSchema.safeParse(call.arguments)
const result = parsed.success
? await executeWithTimeout(tool, parsed.data)
: invalidArgumentsResult(parsed.error)
state.messages.push(toToolResultMessage(call.id, result))
state.trace.push({ call, result })
}
state.step += 1
}
return stopResult(state)
}
先记录包含 tool call 的 assistant 消息,再追加对应 tool result;不能只把结果塞进历史而丢掉发起调用的消息。Rust 分支的 ? 对未知工具直接结束运行,Python/JS/TS 分支则把未知工具作为观察回填,这是两种明确策略,接入时应按产品要求统一。所有分支还需限制单轮调用数量,否则“最多十轮”仍可能包含上千次调用。
4. 错误要进入观察
将错误分成模型可利用的结构:
{
"ok": false,
"error": {
"type": "INVALID_ARGUMENT",
"message": "path is required",
"retryable": true,
"fields": { "path": "missing" }
}
}
参数错误可以让模型修正;权限拒绝通常需要换方案;超时可按幂等性决定重试;业务校验失败则应补充上下文或终止。
5. 最小验证清单
- 工具调用与结果 ID 对应;
- 未知工具不会执行;
- 非法参数不会进入 handler;
- 工具异常转成结构化结果;
- 超过最大步数会停止;
- 用户取消可中断模型和工具;
- 最终答案之前执行完成度验证;
- trace 能重建每一步。
参考资料
6. 一轮运行的协议边界
一轮并不是“调用一次模型”这么简单,而是以下协议的组合:
运行时必须保持三个不变量:
- 协议不变量:每个调用都有唯一 ID,每个结果引用原调用;未知工具和非法参数不会进入 handler。
- 状态目标:模型所见历史应与持久化状态相符。崩溃可能发生在“外部动作成功,但本地结果尚未保存”之间;只保存历史不能保证副作用恰好一次。写操作需要服务端幂等键、同事务去重或状态查询,未知结果不可直接当失败重发。
- 资源不变量:每轮都先检查 deadline、取消信号与预算,模型也不能延长运行时强制上限。
7. 决策、执行和验证要使用不同类型
from dataclasses import dataclass, field
from typing import Any, Literal
@dataclass(frozen=True)
class ToolDecision:
kind: Literal["tool"]
call_id: str
name: str
arguments: Any
@dataclass(frozen=True)
class ToolResult:
ok: bool
call_id: str
data: Any | None = None
evidence: tuple["EvidenceItem", ...] = ()
error: "ToolError | None" = None
@dataclass(frozen=True)
class FinalResult:
ok: bool
stop_reason: Literal[
"COMPLETED", "MAX_STEPS", "TIMEOUT", "CANCELLED", "ERROR"
]
evidence: tuple["EvidenceItem", ...] = ()
answer: str | None = None
use serde_json::Value;
struct ToolDecision {
kind: &'static str,
call_id: String,
name: String,
arguments: Value,
}
enum ToolResult {
Ok {
call_id: String,
data: Value,
evidence: Vec<EvidenceItem>,
},
Err {
call_id: String,
error: ToolError,
},
}
enum StopReason {
Completed,
MaxSteps,
Timeout,
Cancelled,
Error,
}
struct FinalResult {
ok: bool,
answer: Option<String>,
stop_reason: StopReason,
evidence: Vec<EvidenceItem>,
}
/**
* @typedef {{
* kind: 'tool',
* callId: string,
* name: string,
* arguments: unknown
* }} ToolDecision
*
* @typedef {{
* ok: boolean,
* callId: string,
* data?: unknown,
* evidence?: EvidenceItem[],
* error?: ToolError
* }} ToolResult
*
* @typedef {{
* ok: boolean,
* answer?: string,
* stopReason: 'COMPLETED'|'MAX_STEPS'|'TIMEOUT'|'CANCELLED'|'ERROR',
* evidence: EvidenceItem[]
* }} FinalResult
*/
type ToolDecision = {
kind: 'tool'
callId: string
name: string
arguments: unknown
}
type ToolResult =
| { ok: true; callId: string; data: unknown; evidence: EvidenceItem[] }
| { ok: false; callId: string; error: ToolError }
type FinalResult = {
ok: boolean
answer?: string
stopReason: 'COMPLETED' | 'MAX_STEPS' | 'TIMEOUT' | 'CANCELLED' | 'ERROR'
evidence: EvidenceItem[]
}
不要把三者压成一个任意 JSON。ToolDecision 是模型建议;ToolResult 是运行时事实;FinalResult 是经过完成度验证后的外部契约。类型分开后,日志、重放、统计和错误处理都会更清晰。
8. 从最小实现到生产 Runner
生产 Runner 还需增加:并行调用并发上限、幂等键、checkpoint、流式事件、审批暂停与恢复、上下文压缩、trace/span、模型与工具重试的独立策略,以及最终产物的语义验证。每增加一个机制,都应配一个确定性测试用例,而不是只靠对话试跑。
参考:OpenAI Agents SDK 的 Agent loop。
先用假模型把循环跑明白
第一次做循环,可以让“模型”按顺序返回两条固定消息:先请求读取工单,再根据工具结果结束。这样无需 API 密钥,也能观察调用 ID、参数校验、结果回填和停止条件。
正常路径跑通以后,换成未知工具、错误参数和始终要求继续的三个假响应。分别检查:错误是否作为观察返回、工具有没有被误执行、最大轮数是否真正结束任务。等这些行为稳定,再换成实际模型适配器。
对照 Hermes 的真实回合生命周期,可以看到框架还要处理取消、预算和压缩等问题。它们是接入真实环境后逐步增加的责任;本页前面的伪代码不能被当成已经包含所有这些能力的完整 SDK。
动手跑:不接真实模型也能测试运行规则
仓库新增了 Agent Loop 练习。在项目根目录执行:
node --test examples/agent-loop/loop.test.mjs
先读第一个测试,观察工具结果如何回到下一轮“假模型”;再看拒绝权限、错误参数、重复调用、权限撤销、步数耗尽、取消和超时。它只读取内存中的练习数据,不需要 API Key。运行成功后,尝试故意删掉权限判断,确认对应测试会失败,再恢复代码。
这个小运行时每轮只处理一个工具调用,使用自定义消息格式;内存回执只在当前运行内有效。超时停止等待并发出取消信号,不会撤销已经发生的外部写入,也不能强制打断阻塞的 JavaScript。接入真实 SDK 前,先读练习 README 的边界说明。
本节的核验依据
2026-10-25 查阅。下面的链接支持本节的机制说明;练习场景和选型建议是本教程的教学设计。